

1. Kontekst rynkowy i ramy biznesowe (Executive Summary)
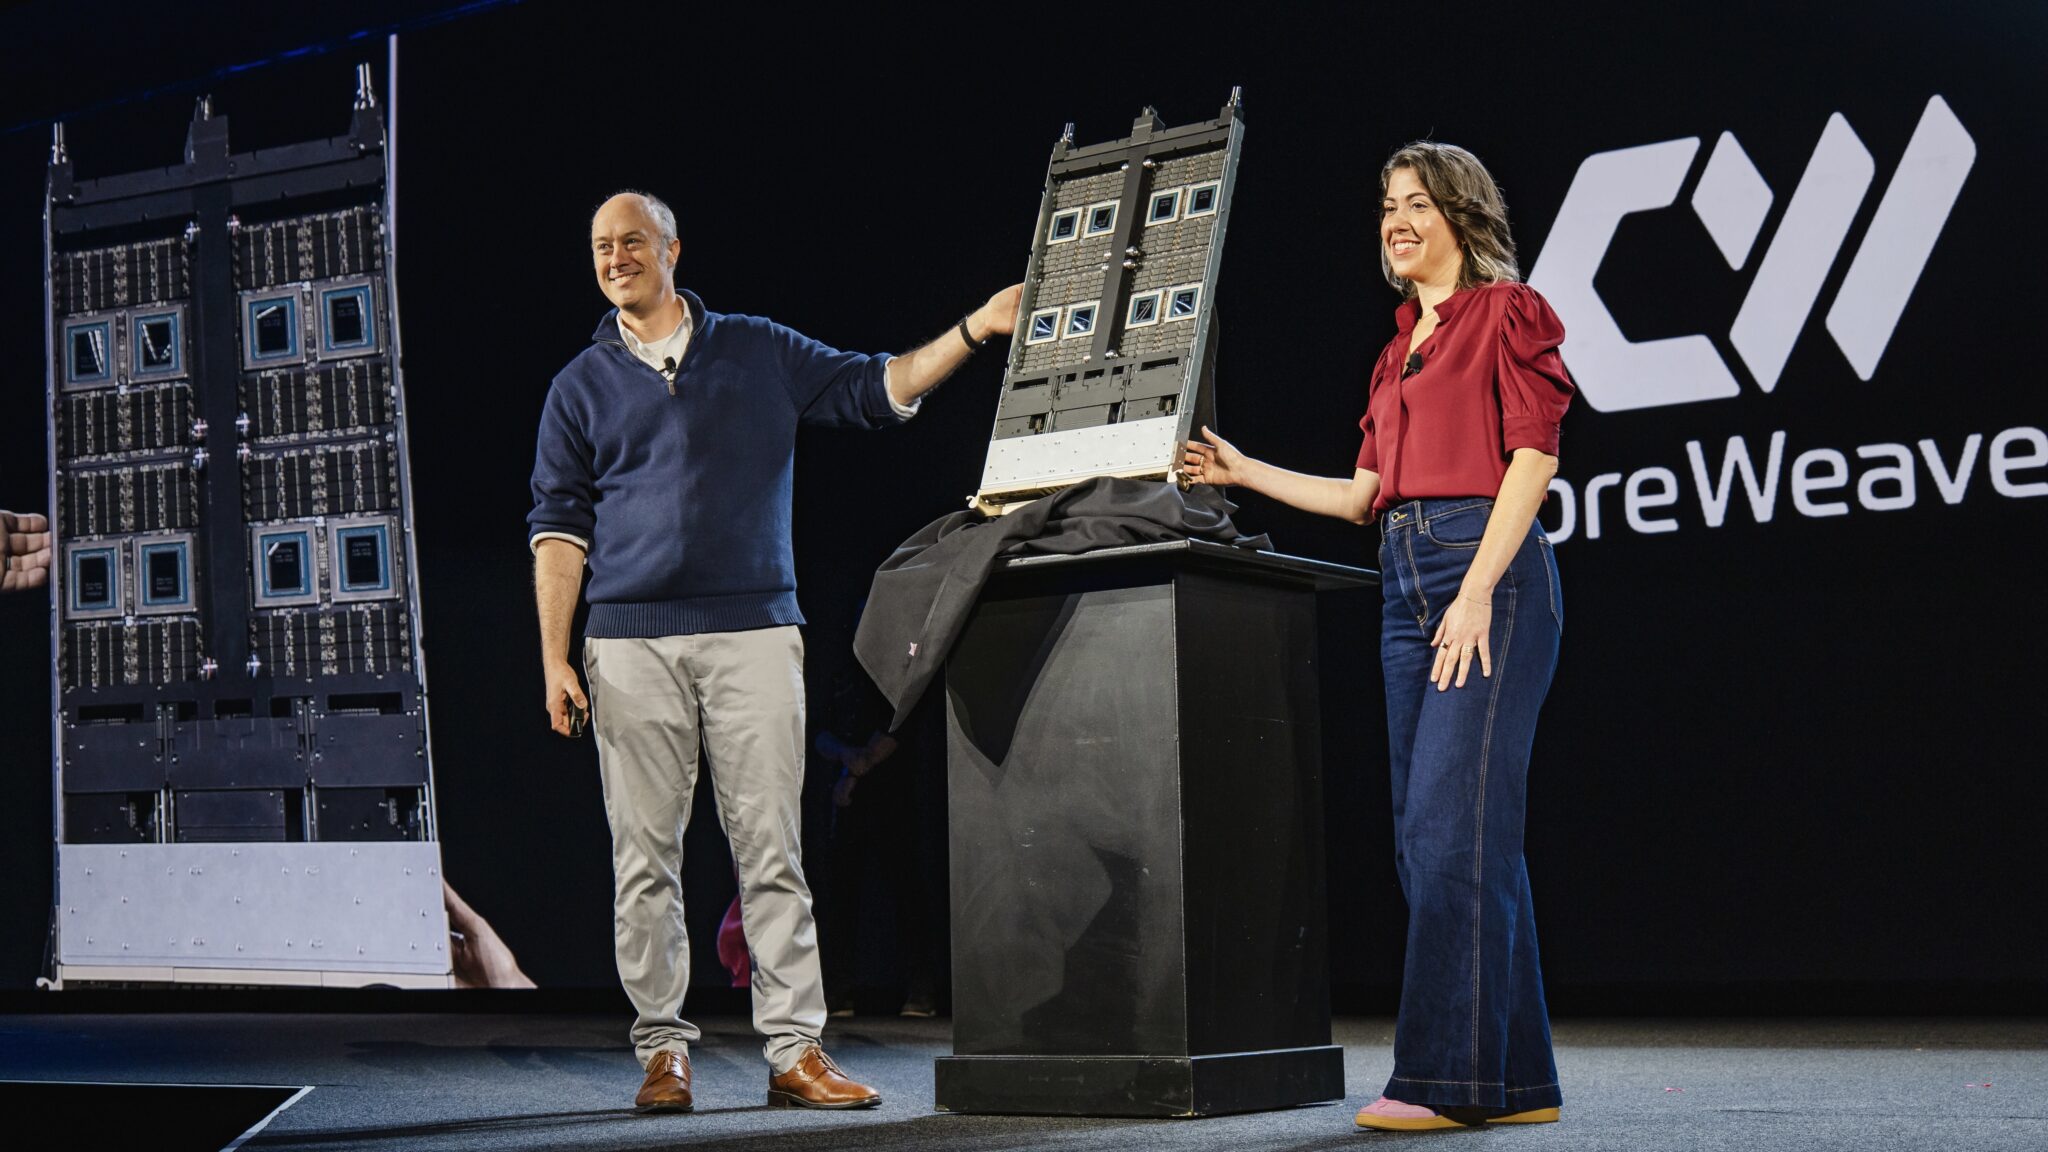
Ogłoszenia ze sceny CoreWeave Fully Connected w San Francisco — gdzie zaprezentowano integrację najnowszej generacji sprzętu NVIDIA (architektura Vera Rubin) z infrastrukturą chmurową zoptymalizowaną pod agentyczną AI — są czymś znacznie więcej niż branżowym newsem. To sygnał rynkowy, który każdy dyrektor techniczny, CIO i właściciel firmy w Polsce powinien czytać jako instrukcję obsługi nowej epoki obliczeniowej.
Przez niemal dekadę CoreWeave budowało swoją platformę w ścisłej współinżynierii z NVIDIA — warstwy compute, networking i oprogramowania zostały zaprojektowane nie jako generyczne chmury publiczne, lecz jako infrastruktura natywna dla AI. Efektem jest zdolność do zamknięcia pętli: od trenowania modeli, przez fine-tuning, aż po produkcyjne wdrożenie agentów AI — bez zmiany dostawcy, bez utraty wydajności na granicy systemu.
Dla polskich przedsiębiorstw i działów IT ta zmiana ma konkretne, strategiczne konsekwencje:
- Bariera wejścia w produkcyjną AI dramatycznie spada — co oznacza, że konkurenci wdrożą agentów szybciej niż kiedykolwiek wcześniej.
- Brak własnej strategii infrastrukturalnej AI staje się ryzykiem biznesowym, a nie tylko technicznym niedopatrzeniem.
- Modele wyceniane na podstawie tokenów i GPU-godzin zastępują tradycyjne licencje — zarządy muszą zrozumieć nową ekonomię kosztów.
- Agenci AI w środowiskach produkcyjnych wymagają innej architektury niż pilotażowe chatboty — i zdecydowanie innej polityki bezpieczeństwa.
W tym artykule nie streszczam doniesień z San Francisco. Zamiast tego, jako Główny Architekt IT z ponad 23-letnim doświadczeniem w budowaniu krytycznych systemów dla polskiego biznesu, przekładam globalny trend na konkretną architekturę, checklistę wdrożeniową i kalkulację ROI — którą możesz zabrać na najbliższe spotkanie zarządu.
2. Dogłębna analiza techniczna i wektory ryzyka
Czym różni się agentyczna AI od tradycyjnego ML?
Modele predykcyjne pierwszej generacji (klasyfikatory, regressory, nawet pierwsze LLM-y w trybie stateless) były stosunkowo przewidywalne architektonicznie: batch job, model, wynik. Agentyczna AI (Agentic AI) to zupełnie inny paradygmat — system autonomicznie planuje wieloetapowe zadania, wywołuje zewnętrzne narzędzia (API, bazy danych, systemy ERP), podejmuje decyzje warunkowe i iteruje w pętli bez ciągłego nadzoru człowieka.
To fundamentalna zmiana wymagań infrastrukturalnych:
- Latencja staje się krytyczna — agent wywołujący 15 kroków narzędzi przy latencji 500 ms na krok generuje 7,5 sekundy oczekiwania na odpowiedź. Przy 100 ms — 1,5 sekundy. Różnica decyduje o użyteczności produktu.
- Stan sesji musi być persistentny i spójny — agent "pamięta" kontekst między krokami; błąd spójności transakcyjnej może skutkować zduplikowanymi zamówieniami, błędnymi fakturami lub wyciekami danych.
- Przepustowość inference ≠ przepustowość trenowania — klaster GPU zoptymalizowany pod training (duże batch, FP16, NVLink) działa inaczej niż infrastruktura inference (małe batch, niskie latencje, wiele równoległych sesji). Wiele firm wpada w pułapkę używania tych samych zasobów do obu zadań.
- Koszty tokenów rosną nieliniowo — agent z rozbudowanym kontekstem (RAG + historia kroków) generuje wielokrotnie więcej tokenów niż prostszy model. Bez monitoringu koszt może eksplodować w ciągu doby.
Kluczowe wektory ryzyka infrastrukturalnego
Single Point of Failure w warstwie orkiestracji: jeśli orchestrator agenta (LangChain, CrewAI, własna implementacja) pada, padają wszystkie równoległe sesje. W środowisku produkcyjnym brak klastrowania tej warstwy to katastrofa SLA.
Eksfiltracja danych przez prompt injection: agent z dostępem do wewnętrznych baz danych (ERP, CRM, kadry) jest wektorem ataku dla prompt injection — złośliwy użytkownik może nakłonić model do ujawnienia poufnych danych poprzez spreparowane wejście. To nie jest teoretyczne zagrożenie — pierwsze incydenty produkcyjne już zostały zaraportowane w branży finansowej.
Vendor lock-in na poziomie modelu i infrastruktury: wybór jednego dostawcy modelu i jednej chmury GPU bez strategii exit może oznaczać uzależnienie porównywalne do legacy ERP z lat 90. Architektura powinna od pierwszego dnia zakładać możliwość zamiany modelu.
Brak audytowalności decyzji agenta: w środowiskach regulowanych (finanse, zdrowie, przetwarzanie odpadów z BDO) każda decyzja systemu musi być rekonstruowalna. Domyślne implementacje agentów nie logują pełnego łańcucha wywołań.
Problemy z przechowywaniem modeli i artefaktów: modele fine-tuned ważą dziesiątki GB; bez właściwego zarządzania artefaktami (MLflow, DVC, S3-compatible storage) wersjonowanie staje się niemożliwe, a rollback po błędnym deploymencie — katastrofalnie długi.
3. Architektura rozwiązania i przewodnik wdrożeniowy krok po kroku
Wzorcowa architektura produkcyjnej agentycznej AI dla enterprise
Poniżej przedstawiam sprawdzoną architekturę referencyjną dla polskich firm wdrażających agentyczną AI w środowisku produkcyjnym. Architektura zakłada hybrydowe środowisko: prywatna infrastruktura on-premise (Proxmox VE + GPU) + chmura publiczna (AWS/GCP) dla elastycznego skalowania inference.
┌─────────────────────────────────────────────────────────┐
│                    WARSTWA DOSTĘPU                       │
│  API Gateway (Kong/Traefik) + WAF + Rate Limiting        │
│  mTLS między serwisami | OAuth2 / OIDC                   │
└──────────────────────────┬──────────────────────────────┘
                           │
┌──────────────────────────▼──────────────────────────────┐
│              WARSTWA ORKIESTRACJI AGENTÓW                │
│  Agent Orchestrator (HA, min. 3 instancje)               │
│  Task Queue: Redis Cluster / RabbitMQ                    │
│  Session Store: PostgreSQL 16 (ACID) + pgvector          │
│  Vector DB: Qdrant / Weaviate (HA mode)                  │
└──────────────────────────┬──────────────────────────────┘
                           │
┌──────────────────────────▼──────────────────────────────┐
│                WARSTWA INFERENCE (GPU)                   │
│  On-prem: Proxmox VE + GPU passthrough (A100/H100)       │
│  vLLM / Triton Inference Server                          │
│  Load Balancer: HAProxy (health checks /health)          │
│  Autoscaling: k3s / Kubernetes HPA                       │
│  Chmura (burst): AWS p4d / GCP A3 (spot instances)       │
└──────────────────────────┬──────────────────────────────┘
                           │
┌──────────────────────────▼──────────────────────────────┐
│              WARSTWA DANYCH I INTEGRACJI                 │
│  ERP (mojafirma.io API), CRM, Magazyn                    │
│  PostgreSQL + TimescaleDB (logi, metryki, audit)         │
│  MinIO S3 (artefakty modeli, backup embeddings)          │
│  MLflow (rejestr modeli + eksperymentów)                 │
└──────────────────────────┬──────────────────────────────┘
                           │
┌──────────────────────────▼──────────────────────────────┐
│             MONITORING I OBSERVABILITY                   │
│  Prometheus + Grafana (GPU util, latency, token/s)       │
│  Loki (logi agentów) | Jaeger (distributed tracing)      │
│  Alertmanager → PagerDuty / SMS                          │
└─────────────────────────────────────────────────────────┘
Krok 1: Przygotowanie infrastruktury bazowej (Proxmox VE + GPU)
Dla on-premise inference z kartami GPU instalacja sterowników i konfiguracja passthrough w Proxmox VE:
# Debian 12 (Bookworm) — instalacja sterowników NVIDIA
apt update && apt install -y linux-headers-$(uname -r) build-essential
wget https://developer.download.nvidia.com/compute/cuda/repos/debian12/x86_64/cuda-keyring_1.1-1_all.deb
dpkg -i cuda-keyring_1.1-1_all.deb
apt update && apt install -y cuda-toolkit-12-4 nvidia-driver-550

# Weryfikacja
nvidia-smi

# IOMMU dla GPU passthrough w Proxmox (grub)
sed -i 's/GRUB_CMDLINE_LINUX_DEFAULT="quiet"/GRUB_CMDLINE_LINUX_DEFAULT="quiet intel_iommu=on iommu=pt"/' /etc/default/grub
update-grub && reboot
Krok 2: Wdrożenie vLLM jako serwer inference z HA
# docker-compose.yml — vLLM inference server (przykład z modelem Llama-3)
version: '3.8'
services:
  vllm-primary:
    image: vllm/vllm-openai:latest
    runtime: nvidia
    environment:
      - NVIDIA_VISIBLE_DEVICES=0,1
    command: >
      --model meta-llama/Llama-3-70b-instruct
      --tensor-parallel-size 2
      --max-model-len 32768
      --gpu-memory-utilization 0.90
      --enable-prefix-caching
      --served-model-name llama3-enterprise
    ports:
      - "8000:8000"
    volumes:
      - /data/models:/root/.cache/huggingface
    healthcheck:
      test: ["CMD", "curl", "-f", "http://localhost:8000/health"]
      interval: 30s
      timeout: 10s
      retries: 3
    deploy:
      resources:
        reservations:
          devices:
            - capabilities: [gpu]
Krok 3: Reguła backupu 3-2-1 dla artefaktów AI
Modele fine-tuned, bazy wektorowe i rejestry MLflow muszą być objęte strategią backupu 3-2-1:
- 3 kopie: kopia produkcyjna + backup lokalny (MinIO on-prem) + backup zdalny (S3 AWS/B2 Backblaze)
- 2 nośniki: dyski NVMe lokalne + obiektowy storage zdalny
- 1 kopia offsite: szyfrowana kopia w innej lokalizacji geograficznej (min. 200 km od DC)
# Skrypt backupu modeli do MinIO (cron, codziennie o 02:00)
#!/bin/bash
TIMESTAMP=$(date +%Y%m%d_%H%M%S)
MODEL_DIR="/data/models/fine-tuned"
MINIO_BUCKET="s3://ai-models-backup"

# Backup z weryfikacją sumy kontrolnej
mc mirror --overwrite --md5 $MODEL_DIR ${MINIO_BUCKET}/$(hostname)/${TIMESTAMP}/
echo "Backup completed: ${TIMESTAMP}" >> /var/log/ai-backup.log

# Test DR — weryfikacja odczytu co tydzień (osobny cron)
# mc ls ${MINIO_BUCKET} --recursive | tail -1 | awk '{print $5}' | xargs mc cat > /dev/null
4. Inżynieryjna checklista wdrożeniowa i audytowa
- ☐ Inwentaryzacja GPU i sterowników: zweryfikuj kompatybilność CUDA Toolkit z wybranym frameworkiem inference (vLLM, TGI, Triton). Niekompatybilne wersje są najczęstszą przyczyną nieudanych deploymentów.
- ☐ Segregacja sieci: inference API nie powinno być dostępne bezpośrednio z internetu — wymagaj przejścia przez API Gateway z WAF i rate limitingiem (max. N req/min per token API key).
- ☐ Konfiguracja HA orkiestratora: minimum 3 instancje agenta za load balancerem; test failover co kwartał (wyłącz jedną instancję i zmierz czas przejęcia ruchu).
- ☐ Audit trail wszystkich wywołań narzędzi: każdy tool call agenta logowany do niezmienialnego storage (append-only log w PostgreSQL lub Loki z retention min. 12 miesięcy).
- ☐ Limity kosztowe na poziomie API: ustaw hard limit tokenów/dobę per projekt i per użytkownik; alert przy przekroczeniu 80% budżetu.
- ☐ Testy prompt injection: przed produkcją przeprowadź testy bezpieczeństwa (red teaming) z zestawem złośliwych promptów; udokumentuj wyniki i wdrożone mitigacje.
- ☐ Wersjonowanie modeli w MLflow: każdy deploy modelu zarejestrowany z tagiem wersji, hashiem committu kodu i wynikami benchmarku jakościowego (MMLU, własne eval sety).
- ☐ Test Disaster Recovery: co 6 miesięcy pełny test odtworzenia infrastruktury AI ze snapshotu (RTO < 4h, RPO < 1h dla systemów produkcyjnych).
- ☐ Monitoring GPU utilization i latencji P99: alerty gdy GPU util < 30% (marnowanie zasobów) lub latencja P99 > zdefiniowanego SLA (np. 2000 ms dla agenta ERP).
- ☐ RODO i lokalizacja danych: dane osobowe przetwarzane przez agenta nigdy nie opuszczają EOG; prywatne instancje modeli on-premise lub w europejskich regionach chmury (eu-central-1 AWS, europe-west4 GCP).
- ☐ Dependency pinning: wszystkie wersje bibliotek (transformers, langchain, vllm) zablokowane w requirements.txt/pyproject.toml; automatyczny skan CVE przy każdym buildzie CI/CD.
- ☐ Capacity planning na 12 miesięcy: projekcja wzrostu liczby agentów i wolumenu tokenów; zarezerwuj 30% nadmiarowej pojemności GPU na burst traffic.
5. Wymogi prawne, podatkowe i zgodność regulacyjna
Dyrektywa NIS2 i systemy AI w infrastrukturze krytycznej
Dyrektywa NIS2 (implementowana w Polsce ustawą o cyberbezpieczeństwie, nowelizacja 2024–2025) obejmuje dostawców chmury, usług zarządzanych i kluczowych systemów informatycznych. Firmy wdrażające agentyczną AI w procesach krytycznych (finanse, logistyka, zdrowie, energetyka) muszą:
- Przeprowadzić analizę ryzyka NIS2 dla nowych systemów AI przed wdrożeniem produkcyjnym.
- Wdrożyć zarządzanie incydentami z obowiązkiem notyfikacji CSIRT w ciągu 24 godzin od wykrycia poważnego incydentu.
- Zapewnić bezpieczeństwo łańcucha dostaw — ocena ryzyka dostawców modeli AI (w tym modeli open-source pobieranych z HuggingFace).
Rozporządzenie DORA (dla sektora finansowego)
Od 17 stycznia 2025 r. firmy z sektora finansowego podlegają rozporządzeniu DORA (Digital Operational Resilience Act). Agentyczna AI używana w procesach finansowych (automatyczne faktury, analiza ryzyka kredytowego, trading algorytmiczny) musi spełniać wymogi:
- Testowanie odporności operacyjnej (TLPT — Threat-Led Penetration Testing) co najmniej raz na 3 lata.
- Zarządzanie ryzykiem ICT z dokumentacją architektury systemów AI.
- Rejestr umów z dostawcami ICT — w tym dostawcami API modeli językowych.
RODO i przetwarzanie danych przez agenty AI
Agent AI przetwarzający dane osobowe (imiona klientów, NIP, PESEL, dane transakcyjne) jest administratorem lub procesorem danych w rozumieniu RODO. Kluczowe wymogi:
- Podstawa prawna przetwarzania musi być określona przed uruchomieniem agenta (art. 6 RODO).
- Zakaz transferu danych poza EOG bez odpowiednich zabezpieczeń (standardowe klauzule umowne, BCR) — dotyczy wysyłania danych do API modeli hostowanych poza UE.
- Prawo do wyjaśnienia decyzji (art. 22 RODO) — jeśli agent podejmuje decyzje wywierające istotny wpływ na osoby fizyczne (np. odmowa kredytu), wymagany jest mechanizm wyjaśnialności (XAI).
Unijne Rozporządzenie o AI (EU AI Act)
EU AI Act wchodzi w życie stopniowo w latach 2024–2027. Agenty AI wysokiego ryzyka (zatrudnienie, edukacja, infrastruktura krytyczna, wymiar sprawiedliwości) wymagają obowiązkowej oceny zgodności, rejestracji w bazie UE i audytu przez jednostkę notyfikowaną. Firmy powinny już teraz klasyfikować swoje systemy AI według kategorii ryzyka.
6. Analiza kosztów (TCO) vs Zwrot z inwestycji (ROI)
Model kosztowy — infrastruktura AI on-premise vs chmura
Decyzja „build vs buy" dla infrastruktury AI jest bardziej skomplikowana niż dla tradycyjnych systemów. Poniżej przykładowa kalkulacja TCO dla firmy zatrudniającej 200 pracowników, wdrażającej agenta AI w procesach back-office:
Scenariusz A — chmura publiczna (API zewnętrzne):
Koszt tokenów: 50M tokenów/miesiąc × $0.003/1K = $150/miesiąc (~600 PLN)
Dodatkowe: monitoring, API gateway, dev hours = $500/miesiąc
Łącznie: ~$650/miesiąc ($7 800/rok)
Scenariusz B — on-premise GPU (A100 40GB SXM4):
CAPEX: 1× A100 server = ~250 000 PLN (amortyzacja 5 lat = 50 000 PLN/rok)
OPEX: energia (~$200/miesiąc), administracja (1 dzień/miesiąc inżyniera) = ~2 000 PLN/miesiąc
Łącznie rok 1: ~74 000 PLN | rok 3+: ~24 000 PLN/rok
Wniosek dla zarządu: przy wolumenie poniżej 100M tokenów/miesiąc i mniej niż 3 modelach chmura publiczna (API zewnętrzne) ma niższe TCO. Powyżej tego progu — lub przy wymaganiach RODO/bezpieczeństwa blokujących zewnętrzne API — inwestycja w on-premise GPU staje się opłacalna w perspektywie 18–24 miesięcy.
ROI z wdrożenia agenta AI w procesach operacyjnych
Nasze wdrożenia pokazują następujące typowe oszczędności dla polskich MŚP:
- Automatyzacja przetwarzania faktur (AP/AR): redukcja czasu obsługi o 70–80% → oszczędność 2–4 etatów rocznie → ROI dodatni po 6–9 miesiącach.
- Agent wsparcia technicznego (Tier 1): obsługa 60–80% zapytań bez udziału człowieka → redukcja kosztów support desk o 40–60%.
- Automatyzacja raportowania i compliance: generowanie JPK, raportów BDO, zestawień magazynowych w sekundy zamiast godzin → eliminacja błędów ludzkich (średni koszt błędu w deklaracji podatkowej: 5 000–50 000 PLN kary + koszty korekty).
7. Najczęściej zadawane pytania (FAQ)
Czy firma bez własnego działu AI może wdrożyć agenta produkcyjnego?
Tak, pod warunkiem właściwego partnerstwa technologicznego. Kluczowe jest posiadanie sprawdzonej infrastruktury serwerowej (lub dostępu do niej przez zaufanego dostawcę managed services), jasno zdefiniowanego use case'u biznesowego i procesu testowania bezpieczeństwa. Wiele naszych wdrożeń dla MŚP zaczynało od zunifikowanego API (OpenAI/Claude) na zarządzanej infrastrukturze chmurowej, stopniowo przechodząc do modeli prywatnych w miarę wzrostu wolumenu i wymagań bezpieczeństwa.
Jak zapewnić wysoką dostępność (HA) dla agenta AI w środowisku produkcyjnym?
Architektura HA dla agentycznej AI wymaga klastrowania na każdej warstwie: orkiestracja (min. 3 repliki), kolejkowanie zadań (Redis Sentinel lub Cluster), baza wektorowa (Qdrant w trybie rozproszonym) i warstwa inference (min. 2 nody GPU za load balancerem). Krytyczne jest wdrożenie health checków z automatycznym restartowaniem nieodpowiadających serwisów (Kubernetes liveness/readiness probes lub docker-compose healthcheck). SLA 99,9% wymaga dodatkowo przetestowanego scenariusza failover co kwartał.
Jak kontrolować koszty inference, aby uniknąć nieprzewidzianych wydatków?
Kontrola kosztów tokenów wymaga wielowarstwowego podejścia: (1) limity per-user i per-project na poziomie API Gateway, (2) monitoring w czasie rzeczywistym zużycia tokenów (Prometheus gauge + alert Grafana przy 80% budżetu), (3) optymalizacja promptów i kontekstu (skrócenie system prompt, prefix caching w vLLM, kwantyzacja modelu do INT8/AWQ), (4) harmonogramowanie batch tasków na godziny niskiego obciążenia (off-peak). Dobrze skonfigurowana architektura potrafi zredukować zużycie tokenów o 40–60% bez utraty jakości odpowiedzi.
Jakie są minimalne wymagania sprzętowe dla prywatnego modelu LLM klasy enterprise?
Dla modelu 7B (Mistral 7B, Llama 3 8B) wystarczy 1× GPU 24GB VRAM (np. RTX 4090 lub A10G) — odpowiedni dla pilotaży i małego ruchu (do 10 concurrent users). Dla modelu 70B (Llama 3 70B, Mixtral 8×7B) potrzebne są minimum 2× A100 80GB lub 4× A100 40GB (tensor parallelism). Dla środowisk enterprise produkcyjnych rekomendujemy minimum 4× H100 80GB z NVLink dla modeli 70B+, zapewniając przepustowość inference powyżej 100 tokenów/sekundę na użytkownika przy małej latencji. Serwerów CPU nie należy traktować jako alternatywy dla GPU w produkcji — jest to możliwe wyłącznie dla modeli skwantyzowanych (GGUF, Q4) i niskiego ruchu.
8. Dedykowane rozwiązania i wdrożenie w ekosystemie AbejaIT
W AbejaIT nie sprzedajemy AI jako buzzwordu. Od ponad 23 lat budujemy systemy krytyczne dla polskich przedsiębiorstw — i wiemy, że technologia musi rozwiązywać konkretne problemy biznesowe, a nie generować nowe. Nasze podejście do wdrożeń agentycznej AI opiera się na sprawdzonej infrastrukturze i integracji z systemami, które firmy już eksploatują.
Jeśli prowadzisz skup złomu lub surowców wtórnych, system ESSW (zlom.io) integruje się z agentami AI automatyzującymi klasyfikację materiałów, generowanie dokumentów BDO i rozliczenia kasowe — eliminując ręczne wprowadzanie danych i błędy ludzkie przy wagach. Podobnie platforma wegiel.io może zostać rozszerzona o agenta AI automatyzującego wystawianie dokumentów dostawy DDW i oświadczeń AKC-WW.
Dla firm korzystających z systemu ERP mojafirma.io integracja agenta AI otwiera możliwości automatycznego przetwarzania przychodzących faktur KSeF, inteligentnego uzgadniania płatności i proaktywnego monitoringu przeterminowanych rozrachunków — bez zmiany systemu finansowo-księgowego.
Zarządy Rodzinnych Ogrodów Działkowych korzystające z systemu dzialkowiec.io mogą wdrożyć agenta odpowiadającego na pytania działkowców 24/7 oraz automatyzującego naliczanie opłat przy zmianach taryf energetycznych.
Niezależnie od branży, podstawą jest sprawdzona infrastruktura. Oferujemy kompleksowe usługi administracji serwerami i infrastruktury IT — od projektowania architektury GPU, przez wdrożenie klastrów Proxmox VE z HA, aż po monitoring 24/7 i reagowanie na incydenty. Dla firm planujących wdrożenia AI przygotowujemy również audyty infrastrukturalnej gotowości AI i roadmapy wdrożeniowe dostosowane do budżetu i skali organizacji.
Jeśli chcesz zamknąć pętlę między ambicją AI a produkcyjną rzeczywistością — skontaktuj się z naszym zespołem inżynierów. Pokażemy Ci, ile konkretnych procesów w Twojej firmie można zautomatyzować w ciągu 90 dni i z jakim ROI.
Źródło inspiracji: NVIDIA Blog