

1. Kontekst rynkowy i ramy biznesowe (Executive Summary)
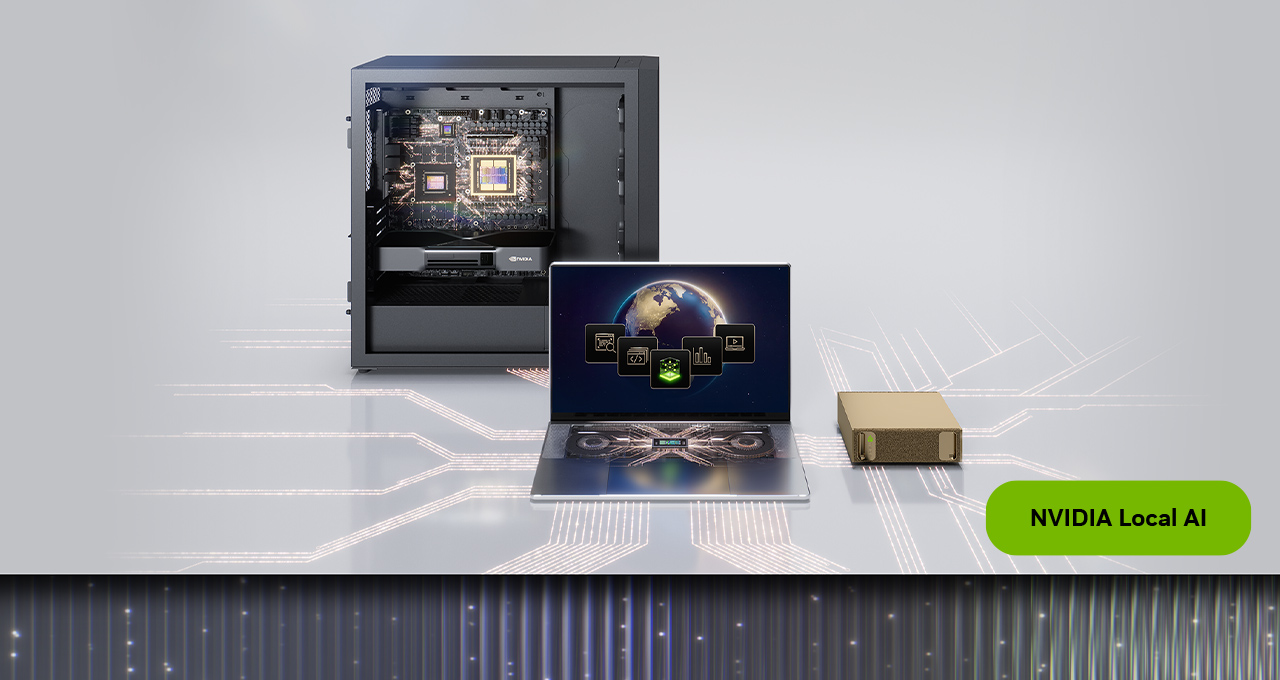
Podczas konferencji GTC Berlin firma NVIDIA zaprezentowała kompletną linię sprzętu do lokalnej sztucznej inteligencji: RTX Spark — kompaktową stację do obsługi agentów AI bezpośrednio na komputerze Windows, DGX Spark — platformę deweloperską dla systemów Linux przeznaczoną do budowania i skalowania aplikacji AI, oraz DGX Station — wydajne urządzenie klasy enterprise do obsługi granicznych modeli językowych na Linuksie, z zapowiedzianą wersją Windows w grudniu. To ogłoszenie nie jest kolejną marketingową demonstracją możliwości GPU — to strategiczny sygnał dla zarządów, dyrektorów technicznych i kierowników IT: era masowej lokalnej infrastruktury AI w przedsiębiorstwach właśnie się rozpoczyna.
Przez ostatnie trzy lata lokalne modele językowe (LLM, ang. Large Language Models) były domeną wyspecjalizowanych laboratoriów badawczych i dużych korporacji dysponujących centrami danych. Koszt wejścia — zarówno finansowy, jak i kompetencyjny — był nieproporcjonalnie wysoki dla małych i średnich przedsiębiorstw. Premiera RTX Spark i DGX Spark burzy ten paradygmat. Po raz pierwszy w historii urządzenie klasy „personal AI supercomputer" mieści się na biurku, kosztuje porównywalnie do wysokiej klasy stacji roboczej, a jednocześnie oferuje przepustowość obliczeniową wystarczającą do obsługi 70-miliardowych modeli parametrycznych w czasie rzeczywistym.
Dla polskich przedsiębiorstw — skupów surowców, składów opału, firm produkcyjnych, biur rachunkowych i ogrodów działkowych — oznacza to konkretne pytania strategiczne: Czy przetwarzać dane firmowe lokalnie czy w chmurze? Jak połączyć lokalną infrastrukturę AI z istniejącymi systemami ERP i magazynowymi? Jakie są ryzyka prawne, kosztowe i bezpieczeństwa? Na te pytania odpowiadamy w niniejszym artykule — z perspektywy ponad 23 lat praktyki inżynieryjnej AbejaIT.
Kluczowa teza: Lokalna AI to nie gadżet technologiczny — to infrastruktura krytyczna, która wymaga takiego samego podejścia architektonicznego jak serwery produkcyjne: planowania pojemności, redundancji, backupu, monitoringu i zgodności regulacyjnej.
2. Dogłębna analiza techniczna i wektory ryzyka
2.1 Architektura lokalnej infrastruktury AI — czym różni się od chmury?
Przetwarzanie modeli językowych lokalnie (on-premises) fundamentalnie różni się od korzystania z API chmurowych (OpenAI, Google Cloud AI, AWS Bedrock). W przypadku rozwiązań chmurowych dane wychodzą poza granice organizacji i są przetwarzane na serwerach dostawcy — co rodzi implikacje związane z RODO, tajemnicą przedsiębiorstwa i ciągłością działania w przypadku awarii dostawcy. Infrastruktura lokalna eliminuje te zagrożenia, ale przenosi pełną odpowiedzialność operacyjną i bezpieczeństwa na organizację.
RTX Spark bazuje na architekturze NVIDIA Blackwell z układem GB10 Grace Blackwell Superchip, oferując 128 GB zunifikowanej pamięci (LPDDR5X) o przepustowości 273 GB/s — co pozwala ładować i inferować modele 70B w całości do pamięci, eliminując kosztowne operacje swapowania. DGX Spark to rozwinięcie tej filozofii na platformę deweloperską z możliwością klastrowania wielu węzłów przez NVIDIA ConnectX-8, natomiast DGX Station to pełnowymiarowa stacja robocza klasy enterprise z redundantnym zasilaniem i chłodzeniem cieczą.
2.2 Wektory ryzyka przy wdrożeniu lokalnej AI
Wdrożenie lokalnej infrastruktury AI generuje specyficzne wektory ryzyka, które zarządy i dyrektorzy IT muszą wziąć pod uwagę już na etapie planowania:
- Ryzyko fizyczne i środowiskowe: Urządzenia klasy DGX Station pobierają od 600 W do 1,6 kW mocy ciągłej. Standardowa serwerownia SMB nieprzygotowana na takie obciążenie termiczne to prosta droga do awarii zasilania lub przegrzania. Wymagany jest klimatyzowany, dedykowany rack lub rozwiązanie chłodzenia cieczą.
- Ryzyko utraty danych modelu i wag: Modele językowe fine-tunowane na własnych danych firmowych (np. cenniki złomu, dokumentacja magazynowa) to aktywa intelektualne. Brak backupu wag modelu oznacza utratę miesięcy pracy i tysięcy złotych inwestycji obliczeniowej.
- Ryzyko ataków na interfejsy API modeli: Lokalne serwery modeli (Ollama, vLLM, LM Studio Server) często uruchamiane są bez uwierzytelniania na domyślnych portach (11434, 8000). W sieci korporacyjnej bez segmentacji każdy pracownik — lub atakujący, który przejął jego stację — może wysyłać zapytania do modelu i eksfiltrować wrażliwe dane przez prompt injection.
- Ryzyko błędów modelowych (halucynacji) w procesach krytycznych: Model językowy zastosowany do automatycznej weryfikacji faktur, kalkulacji podatku akcyzowego od wyrobów węglowych czy generowania kart KPO może popełniać błędy ze stuprocentową pewnością siebie. Brak ludzkiej warstwy weryfikacji to ryzyko finansowe i prawne.
- Ryzyko przestarzenia modelu (model staleness): Modele nie aktualizują się samoczynnie. Wdrożony model z 2024 roku nie będzie znał zmian w przepisach podatkowych z 2025 roku — jeśli nie wdrożono systemu RAG (Retrieval-Augmented Generation) z aktualną bazą wiedzy.
- Ryzyko braku ciągłości działania: Awaria lokalnego węzła AI przy braku redundancji zatrzymuje wszystkie procesy automatyzacji. W przeciwieństwie do chmury, gdzie SLA dostawcy wynosi 99,9%, lokalny węzeł bez klastrowania HA to Single Point of Failure.
3. Architektura rozwiązania i przewodnik wdrożeniowy krok po kroku
3.1 Referencyjna architektura dla MŚP (High Availability Local AI)
Na podstawie ponad 23 lat doświadczeń z wdrożeniami serwerowymi rekomendujemy następującą referencyjną architekturę dla przedsiębiorstwa klasy MŚP chcącego wdrożyć lokalną AI:
- Warstwa obliczeniowa: 1–2 węzły z GPU (NVIDIA RTX 4090 / RTX 5090 / DGX Spark), wirtualizacja przez Proxmox VE 8.x lub Kubernetes (k3s dla MŚP)
- Warstwa przechowywania modeli: lokalny NAS z ZFS (RAIDZ2), minimum 4 TB przestrzeni na wagi modeli i dane treningowe
- Warstwa serwera modeli: Ollama lub vLLM za reverse proxy (Nginx/Caddy) z uwierzytelnianiem API Key
- Warstwa RAG: baza wektorowa Qdrant lub Weaviate z dokumentami firmowymi (cenniki, regulaminy, procedury)
- Warstwa monitoringu: Prometheus + Grafana z alertami na GPU utilization, VRAM pressure, temperature, API latency
- Warstwa backupu: reguła 3-2-1 dla wag modeli: kopia lokalna (NAS), kopia na drugim nośniku (LTO lub drugi NAS), kopia offsite (zaszyfrowana chmura)
3.2 Instalacja i zabezpieczenie serwera Ollama w środowisku produkcyjnym
# 1. Instalacja Ollama na Debianie 12 / Ubuntu 22.04
curl -fsSL https://ollama.com/install.sh | sh

# 2. Konfiguracja nasłuchiwania tylko na localhost (nie 0.0.0.0!)
sudo systemctl edit ollama.service
# Dodaj w sekcji [Service]:
# Environment="OLLAMA_HOST=127.0.0.1:11434"

# 3. Restart i weryfikacja
sudo systemctl daemon-reload && sudo systemctl restart ollama
ss -tlnp | grep 11434
# Oczekiwany wynik: 127.0.0.1:11434

# 4. Nginx reverse proxy z Basic Auth
sudo apt install nginx apache2-utils -y
htpasswd -c /etc/nginx/.htpasswd ai_user

# /etc/nginx/sites-available/ollama-proxy
server {
    listen 443 ssl;
    server_name ai.twojafirma.pl;
    ssl_certificate /etc/letsencrypt/live/ai.twojafirma.pl/fullchain.pem;
    ssl_certificate_key /etc/letsencrypt/live/ai.twojafirma.pl/privkey.pem;

    location / {
        auth_basic "AI API";
        auth_basic_user_file /etc/nginx/.htpasswd;
        proxy_pass http://127.0.0.1:11434;
        proxy_set_header Host $host;
        proxy_read_timeout 300s;
    }
}

# 5. Pobranie modelu (np. Mistral 7B)
ollama pull mistral:7b-instruct

# 6. Monitoring GPU (NVIDIA)
watch -n 2 nvidia-smi --query-gpu=name,temperature.gpu,utilization.gpu,memory.used,memory.total \
  --format=csv,noheader
3.3 Konfiguracja backupu wag modeli (reguła 3-2-1)
# Backup katalogu modeli Ollama na zdalny NAS przez rsync
OLLAMA_MODELS="/usr/share/ollama/.ollama/models"
BACKUP_DEST="[email protected]:/mnt/pool/ai-models-backup"
TIMESTAMP=$(date +%Y%m%d_%H%M%S)

rsync -avz --checksum \
  --log-file="/var/log/ollama-backup-${TIMESTAMP}.log" \
  "${OLLAMA_MODELS}/" \
  "${BACKUP_DEST}/${TIMESTAMP}/"

# Weryfikacja checksumów po backupie
find "${OLLAMA_MODELS}" -type f -name "*.bin" -o -name "*.gguf" \
  | xargs sha256sum > /var/log/models-checksums-${TIMESTAMP}.txt

echo "Backup zakończony: $(date)" | mail -s "AI Model Backup OK" [email protected]
4. Inżynieryjna checklista wdrożeniowa i audytowa
Poniższa lista kontrolna powinna być zweryfikowana przez administratora IT i kierownika projektu przed uruchomieniem produkcyjnym lokalnej infrastruktury AI:
- ✅ Segmentacja sieci: Węzeł AI umieszczony w dedykowanym VLAN-ie, izolowanym od sieci użytkowników końcowych i produkcyjnych systemów ERP przez reguły firewalla (iptables/nftables lub sprzętowy UTM).
- ✅ Uwierzytelnianie API: Serwer modeli (Ollama/vLLM) nasłuchuje wyłącznie na localhost; dostęp zewnętrzny wyłącznie przez reverse proxy (Nginx/Caddy) z API Key lub OAuth2. Brak dostępu anonimowego.
- ✅ Szyfrowanie danych w spoczynku: Dyski z wagami modeli i danymi treningowymi zaszyfrowane (LUKS2 na Linuksie lub BitLocker na Windows).
- ✅ Backup 3-2-1 wag modeli: Potwierdzone kopie na 3 nośnikach (lokalny NAS + zewnętrzny dysk + zaszyfrowana chmura), test odtworzenia przeprowadzony i udokumentowany.
- ✅ Monitoring GPU i systemu: Prometheus + nvidia-smi exporter + Grafana z alertami na temperature > 80°C, VRAM > 90%, disk I/O saturation.
- ✅ Zarządzanie wersjami modeli: System tagowania wersji modeli (np. przez DVC lub prosty rejestr w Git), możliwość rollback do poprzedniej wersji w < 30 minut.
- ✅ Aktualizacja bazy wiedzy RAG: Harmonogram automatycznej reingestii dokumentów firmowych do bazy wektorowej (minimum raz na tydzień lub przy każdej zmianie cennika/procedur).
- ✅ Polityka retencji logów zapytań: Logi zapytań do modelu przechowywane z szyfrowaniem, retencja zgodna z polityką RODO (maksymalny czas przechowywania uzasadniony celem przetwarzania).
- ✅ Test Disaster Recovery: Udokumentowany i przetestowany scenariusz odtworzenia całego węzła AI z backupu w czasie < RTO (Recovery Time Objective) ustalonym dla procesu biznesowego.
- ✅ Ocena skutków dla ochrony danych (DPIA): Przeprowadzona formalna ocena zgodnie z art. 35 RODO, jeśli model przetwarza dane osobowe pracowników, klientów lub kontrahentów.
- ✅ Procedura prompt injection: Wdrożone reguły filtrowania wejść użytkownika (whitelist dozwolonych operacji, blokada instrukcji systemowych w polach użytkownika) dla modeli dostępnych przez interfejs webowy.
- ✅ Zasilanie awaryjne (UPS): Węzeł AI podłączony do UPS-a z minimalnie 15-minutową autonomią + procedura graceful shutdown przy zaniku zasilania (skrypt integrujący apcupsd lub NUT).
5. Wymogi prawne, podatkowe i zgodność regulacyjna
5.1 Dyrektywa NIS2 i lokalna infrastruktura AI
Dyrektywa NIS2 (transponowana do polskiego prawa przez nowelizację ustawy o krajowym systemie cyberbezpieczeństwa, planowana implementacja 2024–2025) nakłada obowiązek zarządzania ryzykiem cyberbezpieczeństwa na podmioty ważne i kluczowe. Wdrożenie lokalnej infrastruktury AI, która przetwarza dane operacyjne przedsiębiorstwa, kwalifikuje się jako zasób ICT objęty wymogami NIS2 w zakresie: inwentaryzacji aktywów, oceny ryzyka, polityki backupu i ciągłości działania oraz raportowania incydentów do CSIRT NASK w ciągu 24 godzin od wykrycia.
5.2 RODO i przetwarzanie danych przez modele lokalne
Lokalne przetwarzanie danych przez modele AI nie eliminuje automatycznie obowiązków wynikających z RODO. Jeśli model językowy przetwarza dane osobowe (np. imię i nazwisko klienta skupu złomu, dane pracownika, historię transakcji z identyfikatorem osoby fizycznej), organizacja musi: udokumentować podstawę prawną przetwarzania (art. 6 RODO), przeprowadzić DPIA (art. 35 RODO) jeśli przetwarzanie jest wysokiego ryzyka, zapewnić szyfrowanie danych w spoczynku i w tranzycie, oraz wdrożyć politykę retencji i usuwania danych z logów modelu.
5.3 Rozporządzenie DORA dla sektora finansowego
Przedsiębiorstwa z sektora finansowego (w tym firmy faktoringowe obsługujące skupy surowców, biura rachunkowe) objęte rozporządzeniem DORA (Digital Operational Resilience Act, obowiązującym od 17 stycznia 2025 r.) muszą traktować lokalną infrastrukturę AI jako krytyczny zasób ICT podlegający pełnemu reżimowi testów odporności, zarządzania incydentami i oceny ryzyka dostawców technologii (w tym producenta GPU i oprogramowania modelu).
5.4 Regulacje AI Act (UE)
Unijne rozporządzenie w sprawie sztucznej inteligencji (AI Act, wchodzące w życie etapami 2024–2027) klasyfikuje systemy AI według poziomów ryzyka. Zastosowania lokalne AI w przedsiębiorstwach do automatyzacji dokumentów, wsparcia decyzji zakupowych czy analizy cen surowców mieszczą się generalnie w kategorii niskiego lub ograniczonego ryzyka — jednak użycie AI do podejmowania decyzji o pracownikach (np. analiza wydajności) lub do zautomatyzowanego odrzucania transakcji (scoring klientów skupu) może być sklasyfikowane jako ryzyko wysokie, wymagające rejestracji w EU AI Office i wdrożenia systemu zarządzania ryzykiem AI.
6. Analiza kosztów (TCO) vs Zwrot z inwestycji (ROI)
6.1 Całkowity koszt posiadania (TCO) — 3-letni horyzont
Porównajmy trzy scenariusze dla firmy MŚP wykonującej ~10 000 zapytań AI miesięcznie (obsługa dokumentów, wsparcie decyzji, automatyzacja korespondencji):
- Scenariusz A — wyłącznie API chmurowe (GPT-4o / Claude 3.5): Koszt ~0,05–0,15 USD / 1000 tokenów output. Przy intensywnym użyciu (20M tokenów/miesiąc): 1 000–3 000 USD/miesiąc = 36 000–108 000 USD w 3 latach. Do tego: ryzyko wzrostu cen dostawcy, brak kontroli nad danymi, zależność od SLA zewnętrznego.
- Scenariusz B — lokalny węzeł AI (RTX 5090 / DGX Spark): Koszt sprzętu: 15 000–25 000 USD jednorazowo. Energia: ~2 400 kWh/rok × 0,80 PLN = ~1 920 PLN/rok (~480 USD). Administracja: 4h/miesiąc seniora IT = ~240 USD/miesiąc. TCO 3-letni: ~33 000–43 000 USD. Próg rentowności: ok. 14–18 miesięcy przy zastąpieniu API chmurowego.
- Scenariusz C — model hybrydowy (lokalny mały model + API dla złożonych zadań): Optymalny dla większości MŚP. Modele 7–13B lokalnie dla rutynowych zadań, API chmurowe dla zadań wymagających zaawansowanego rozumowania. Redukcja kosztów API o 70–80%, zachowanie elastyczności dla trudnych przypadków.
6.2 Ukryte koszty braku automatyzacji AI
Analiza przypadków z 23 lat praktyki AbejaIT pokazuje, że manualne procesy, które może zastąpić lokalna AI, generują następujące koszty ukryte:
- Ręczna weryfikacja i przepisywanie faktur: 2–4 godziny pracownika dziennie = 20 000–40 000 PLN rocznie na etat
- Błędy w ewidencji magazynowej i ręcznym naliczaniu opłat: kary kontraktowe i korekty podatkowe = 5 000–50 000 PLN/rok (zależnie od skali)
- Czas odpowiedzi na zapytania klientów (bez AI chatbota): utracone kontrakty i rotacja klientów — trudno mierzalne, ale realne
- Koszt manualnego przeszukiwania dokumentacji technicznej przez pracowników: 1–2 godziny dziennie/pracownik × stawka godzinowa
7. Najczęściej zadawane pytania (FAQ)
Czy lokalna AI jest bezpieczniejsza od chmurowej pod kątem RODO?
To zależy od implementacji — nie od lokalizacji. Lokalny model AI może być równie niebezpieczny jak chmurowy, jeśli nie wdrożono szyfrowania danych, kontroli dostępu i logowania operacji. Kluczowa różnica polega na tym, że przy przetwarzaniu lokalnym masz pełną kontrolę nad ścieżką danych i możesz udowodnić organom nadzorczym, że dane nie opuściły organizacji. Chmura wymaga z kolei umowy powierzenia przetwarzania (art. 28 RODO) z dostawcą i zaufania do jego mechanizmów bezpieczeństwa. Dla danych wrażliwych sektora B2B — np. danych klientów skupu złomu, ewidencji wyrobów węglowych — lokalna infrastruktura AI jest rekomendowana przez AbejaIT jako bezpieczniejsza architektonicznie.
Jakie modele językowe najlepiej sprawdzają się w polskojęzycznym środowisku biznesowym?
W 2025 roku czołowe modele do lokalnego uruchomienia z dobrą obsługą języka polskiego to: Mistral 7B / Mistral Large (doskonała jakość przy niskich wymaganiach sprzętowych), Llama 3.1 70B (wymagający co najmniej 48 GB VRAM, ale zbliżony do GPT-4 jakością), Bielik-7B (pierwszy otwartoźródłowy model dedykowany językowi polskiemu, oparty na architekturze Mistral, trenowany na polskojęzycznym korpusie) oraz Gemma 3 27B od Google. Dla zadań specjalistycznych (analiza dokumentów prawnych, fakturowanie, ewidencja podatkowa) rekomendujemy fine-tuning wybranego modelu bazowego na własnych danych firmowych lub implementację RAG z aktualną bazą wiedzy podatkowej i regulacyjnej.
Jak zintegrować lokalny model AI z istniejącym systemem ERP lub magazynowym?
Integracja przebiega przez warstwę API: serwer modelu (Ollama API na porcie 11434 lub vLLM OpenAI-compatible API) jest wywoływany przez backendem systemu ERP za pomocą standardowych zapytań HTTP/REST. W przypadku systemu mojafirma.io AbejaIT, integracja polega na wdrożeniu modułu AI-asystenta, który łączy kontekst z aktualnych danych magazynowych i finansowych (przez bezpieczne API wewnętrzne) z odpowiedziami modelu językowego — bez przesyłania danych poza infrastrukturę klienta. Kluczowe jest wdrożenie mechanizmu RAG z indeksem dokumentów firmowych (faktury, cenniki, procedury magazynowe), który dostarcza modelowi aktualny kontekst biznesowy zamiast polegać wyłącznie na wiedzy treningowej.
Jak zaplanować pojemność (capacity planning) dla węzła AI w MŚP?
Punktem startowym jest oszacowanie liczby równoczesnych użytkowników i charakterystyki zapytań. Dla modelu 7B (np. Mistral 7B Q4_K_M, ~4 GB VRAM) na karcie RTX 4090 (24 GB VRAM) można równolegle uruchomić do 4–5 instancji modelu z przyzwoitą latencją (< 500 ms do pierwszego tokenu). Dla 70B modelu (Llama 3.1 70B Q4) potrzeba minimum 48 GB VRAM — czyli co najmniej dwie karty RTX 4090 lub jedna karta A100/H100. Zasada praktyczna AbejaIT: zaplanuj VRAM na 2x rzeczywiste zapotrzebowanie, uwzględniając KV cache przy długich kontekstach (128K tokenów), batch processing i przyszłe modele o większej liczbie parametrów. Monitoring VRAM pressure przez nvidia-smi lub Prometheus jest obowiązkowy od dnia uruchomienia produkcyjnego.
8. Dedykowane rozwiązania i wdrożenie w ekosystemie AbejaIT
AbejaIT od ponad 23 lat projektuje i wdraża infrastrukturę IT dla polskich przedsiębiorstw — od skupów surowców, przez składy opału, po systemy ERP w chmurze. Wprowadzenie lokalnej AI do ekosystemu klientów AbejaIT to naturalny krok ewolucji — nie rewolucja dla jej własnego dobra, ale konkretna odpowiedź na realne potrzeby operacyjne.
Nasze podejście do wdrożeń AI jest oparte na trzech filarach: bezpieczeństwo danych (lokalne przetwarzanie bez wyjścia danych poza organizację), integracja z istniejącymi systemami (bez konieczności wymiany sprawdzającego się oprogramowania branżowego) oraz mierzalny ROI (wdrażamy tylko to, co realnie skraca czas pracy lub eliminuje błędy kosztujące pieniądze).
W obszarze skupu surowców wtórnych — system ESSW (zlom.io) oferuje integrację z wagami samochodowymi, ewidencją BDO i elektronicznymi kartami KPO. Moduł AI w przygotowaniu umożliwi automatyczne rozpoznawanie frakcji surowców ze zdjęć (computer vision) oraz inteligentne sugestie ceny skupu na podstawie historii transakcji i bieżących notowań giełdowych.
Dla składów węgla i opału — platforma wegiel.io obsługuje pełną ewidencję wyrobów węglowych, oświadczenia AKC-WW i dokumenty dostawy DDW. Planowana integracja z lokalnym modelem AI pozwoli na automatyczne generowanie oświadczeń podatkowych i weryfikację poprawności danych z wagą przed zatwierdzeniem transakcji.
System ERP mojafirma.io — z pełną integracją z Krajowym Systemem e-Faktur (KSeF) — jest naturalną platformą dla wdrożenia asystenta AI do automatyzacji obiegu dokumentów: weryfikacji faktur przychodzących, generowania faktur wychodzących, kontroli płatności i wsparcia decyzji windykacyjnych. Wszystko w modelu lokalnym lub hybrydowym, bez przesyłania danych finansowych do zewnętrznych API.
Zarządzający Rodzinnymi Ogrodami Działkowymi korzystający z platformy dzialkowiec.io znajdą w module AI wsparcie dla automatycznego naliczania opłat, odpowiadania na pytania działkowców przez chatbota 24/7 oraz generowania uchwał i protokołów walnych zebrań na podstawie wprowadzonych danych.
Dla wszystkich powyższych wdrożeń niezbędna jest stabilna, bezpieczna infrastruktura serwerowa. Zespół AbejaIT oferuje kompleksową administrację serwerami i infrastrukturą IT — od projektowania architektury, przez wdrożenie klastrów Proxmox VE i kontenerów Docker, po monitoring 24/7 z alertowaniem i szybką reakcją na incydenty. Jeśli planujesz wdrożenie lokalnej AI w swojej organizacji, zapraszamy na konsultację z zespołem inżynierów AbejaIT — bezpłatną analizę potrzeb i przygotowanie architektury dopasowanej do Twojego środowiska.
Szczegółowe informacje o naszych rozwiązaniach AI dla biznesu oraz audytach i doradztwie IT znajdziesz w dedykowanych sekcjach serwisu AbejaIT.
Źródło inspiracji: NVIDIA Blog